📚 이 글은 마인크래프트 AI 주지스님 워크스루 1편입니다.
① 서피스프로8에서 SLM 가볍게 테스트 – Ollama로 1.5B~3B 모델 로컬 실행해보기
② SLM에게 참고자료를 줬더니, 3B와 8B가 다르다 – Llama 3B vs. 8B RAG 테스트 비교
③ RAG는 결국 ‘프롬프트를 잘 만들어 주는 도구’네
④ RAG 자료창고 짓기 전 알아야 할 것들
⑤ 임베딩을 오해하며 이해하기
⑥ 질문에서 답까지 – RAG 파이프라인, 로컬에서 완성
⑦ 같은 질문, 다른 크기 — 1B/3B/8B가 반야심경에 답하다
서프야, 내가 오해했다
난 2019년산 LG그램, 서피스프로8을 가지고 있다.
마인크래프트에 사찰을 짓고 그 주지스님을 SLM(Small Language Model)으로 만들어 보자,
좀 더 욕심내면 최예진 교수님의 논문을 적용해 보자는 계획을 세우고 나서,
먼저 확인해본 건 이게 내 컴퓨터로 가능한 계획인지였다.
처음엔 서피스프로8에 대해선 알아보지도 않았다.
예뻐서 충동구매했던 서피스프로8은 휴대하기 편한 전용 키보드가 붙어있는 태블릿이라고만 생각했고,
당연히 LG그램이 더 성능 좋은 컴퓨터인줄 알고 써왔다.
그런데 AI에게 LG그램으로 마인크래프트 할 수 있냐고 물어보니까,
세상 긍정적인 구글AI도, 냉소적인 클로드도 시원찮은 반응..
둘 다 ‘설정을 잘 하면 LG그램으로도 할 수 있어요’ 라는 대답.
여기에다 SLM까지 얹는다면..
이틀 정도 김이 빠져있다가,
기대없이 ‘나 서피스프로8도 가지고 있는데 그건 될까?’ 물었더니.
어머 충분하죠! 그럼요~ 라는 반응 ㅎㅎ
알고보니, 서피스프로8이 연산 성능과 디스플레이 사양에서 확연히 앞선단다.
외모만 보고 내가 너무 무시했었구나. 미안하다, 서프.
서피스프로8에서 SLM 로컬 실행, 직접 돌려본 결과
다음으로 서피스프로8에서 SLM을 사용할 수 있는지 확인해봤다.
결론은,
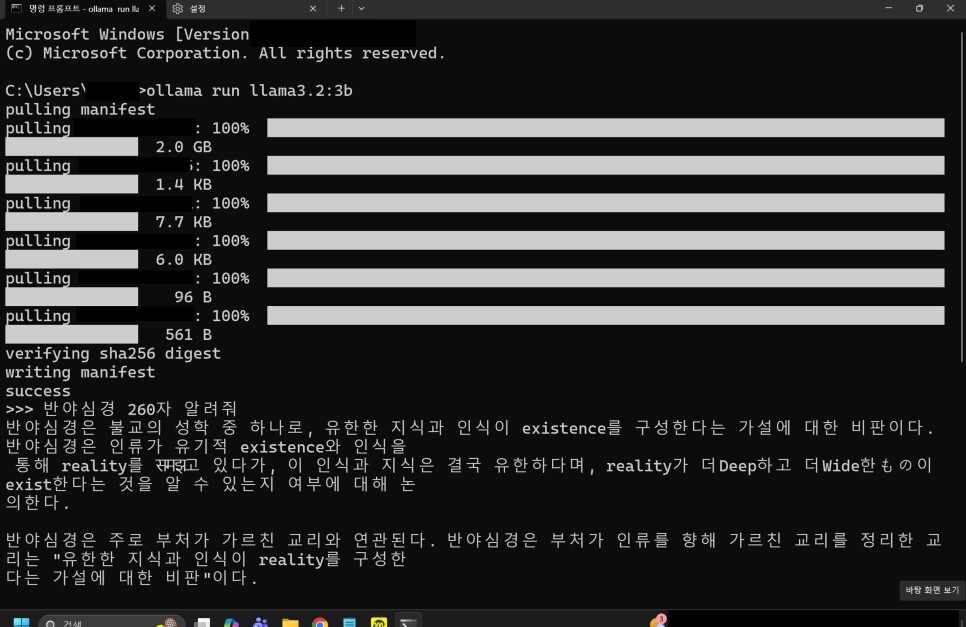
‘서피스프로8에서 SLM 1.5B와 3B(매개변수가 15억개, 30억개인 모델)는 잘 돌아갔다.
Ollama 플랫폼에서 각각의 모델을 로딩하는데 1.5분에서 3.5분 가량이 소요되긴 하지만,
질문하면 답변은 바로 해주는 정도’
문제는 내가 가진 컴퓨터의 성능이 아니었다.
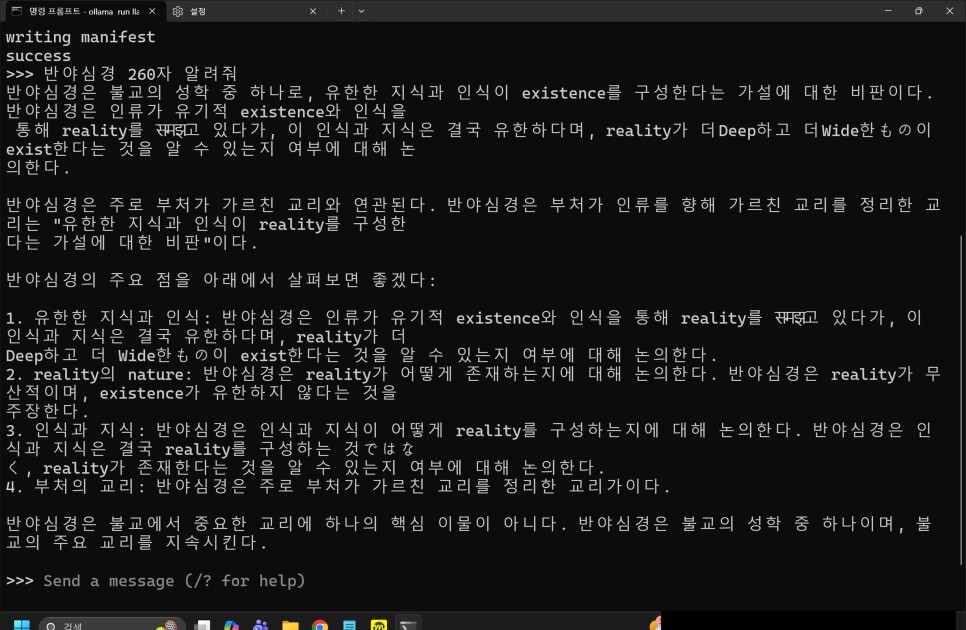
SLM 모델의 할루시네이션이 심했다.
‘반야심경 260자를 알려줘’라는 요청에,
불교경전인 반야심경을 1952년에서 2008년까지 생존한
한국의 대표적인 인류학자이자 철학자라고 소개하고,
‘성지회에서 다루는 교리’, ‘예수와의 관계’ 같이 기독교와 불교 용어를 뒤섞어서
그럴 듯 하지만 전혀 말이 안되는 설명을 했다.
“네가 모르는 건 모른다고 해”라는 시스템 프롬프트를 줬음에도,
답변은 전혀 나아지지 않았다.
심지어 내가 실수로 잘못 입력한 명령어를 자신에게 입력한 프롬프트라고 생각하고
그에 대한 그럴 듯한 답변을 만들어 내기도 했다.
이건.. 모델 자체의 크기와 구조의 한계다.
이 정도로 작은 모델은 학습 과정에서 본 정보의 양 자체가 적어서,
반야심경처럼 비교적 좁은 분야의 지식이 애초에 충분히 들어가 있지 않았을 가능성이 높다.
그리고 “모르면 모른다고 말해”라는 명시적인 지시를 따르지 못한 건..
이건 지식의 문제가 아니라,
지금 자신이 무엇을 알고 모르는지 스스로 판단하는 능력 자체가 모델 크기에 비례하기 때문이라고..
사람도 자신이 뭘 모르는지 알아야 발전이 있다는, 메타인지의 중요성에 대한 얘기들을 한다.
그래서 소크라테스가 ‘너 자신을 알라’고 했을 텐데.
자신이 뭘 아는지 모르는지를 판단하지 못해서 생기는 문제를 AI를 통해 보게 되다니..
뭔가 기분이 묘하다.
이까지 확인한 뒤,
난 이 다음 단계가 SLM을 추가로 훈련시키거나 튜닝하는 거라고 생각했었다.
그런데 클로드가 이 문제는 그렇게 해결할 수 있는 게 아니라고 한다.
추가학습, 파인튜닝은 “이미 아는 것을 더 잘 표현하는 법”을 가르치는 것이지, “원래 없던 지식”을 채워주는게 아니기 때문이라고..
다음 단계: RAG 테스트 계획
다음번 SLM모델로 시도해볼 건 RAG(검색 증강 생성)이다.
모델에게 정답을 묻지 않고, 정답이 될 원문을 직접 건네주고 ‘이걸 자연스럽게 풀어서 말해달라’고 시키는 것.
RAG라는 용어를 얼마전 클로드의 프로젝트 기능을 공부할 때 봤었는데, 그것과 같은 원리라네.
사실 글로 보니까 RAG가 추가 훈련을 의미하는게 아닌가 헛갈리기도 하는데..
RAG 테스트와 그에 대한 좀 더 상세한 이해는 다음에 계속해 보자.
성실하게. 미루지 말고.
(2026.6.29. 네이버 블로그에 포스팅했던 글인데, 이곳으로 이사왔습니다.)
Q. 서피스프로8에서도 SLM을 돌릴 수 있나요?
A. 네, 가능합니다. Ollama로 1.5B, 3B 모델을 실행해봤는데 로딩에 1.5~3.5분 정도 걸릴 뿐, 질문에는 바로 답변했습니다. 문제는 컴퓨터 성능이 아니라 모델 자체의 할루시네이션이었습니다.
Q. SLM에게 시스템 프롬프트로 “모르면 모른다고 말해”라고 지시하면 할루시네이션이 해결되나요?
A. 아니요. 이 지시를 줬는데도 답변은 전혀 나아지지 않았습니다. 이건 지식이 부족해서가 아니라, 자신이 무엇을 알고 모르는지 스스로 판단하는 메타인지 능력 자체가 모델 크기에 비례하기 때문입니다.
Q. SLM을 파인튜닝(추가 학습)하면 할루시네이션이 해결되나요?
A. 아닙니다. 추가 학습이나 파인튜닝은 “이미 아는 것을 더 잘 표현하는 법”을 가르치는 것이지, “원래 없던 지식”을 채워주는 게 아닙니다. 반야심경처럼 좁은 분야의 지식이 애초에 부족한 경우엔 파인튜닝만으로는 해결되지 않습니다.
Q. RAG는 정확히 뭔가요?
A. RAG(검색 증강 생성)는 모델에게 정답을 바로 묻는 대신, 정답이 될 원문(참고자료)을 함께 건네주고 그걸 근거로 답하게 하는 방식입니다. 모델을 추가로 학습시키는 것과는 다른, 추론 시점의 개입입니다.