📚 이 글은 마인크래프트 AI 주지스님 워크스루 2편입니다.
① 서피스프로8에서 SLM 가볍게 테스트 – Ollama로 1.5B~3B 모델 로컬 실행해보기
② SLM에게 참고자료를 줬더니, 3B와 8B가 다르다 – Llama 3B vs. 8B RAG 테스트 비교
③ RAG는 결국 ‘프롬프트를 잘 만들어 주는 도구’네
④ RAG 자료창고 짓기 전 알아야 할 것들
⑤ 임베딩을 오해하며 이해하기
⑥ 질문에서 답까지 – RAG 파이프라인, 로컬에서 완성
⑦ 같은 질문, 다른 크기 — 1B/3B/8B가 반야심경에 답하다
오늘은 SLM으로 RAG 테스트(Retrieval-Augmented Generation, 검색증강생성)를 했다.
지난 테스트 결과 정리
RAG 테스트 결과에 관해 정리하기 전에, 먼저 지난 번 서피스프로8에서 SLM 중 llama와 quen의 1.5B, 3B모델로 테스트 해본 결과를 간략히 보면.
일단 속도는 참을만했다.
모델 로딩에 1.5분에서 3.5분 사이, 답변은 바로 해주는 정도.
문제는 1.5~3B인 SLM 모델의 ①심한 할루시네이션 증상, ②할루시네이션을 해결하기 위해 “모르면 모른다고 말해”라고 시스템 프롬프트를 줬음에도 자신이 뭘 알고 뭘 모르는지 그 자체를 스스로 판단하지 못한다는 것.
둘 다 모델이 작아서 생기는 전형적인 증상이라고.
이 문제를 해결하기 위해 RAG 구조를 적용해 보는게 좋겠다는 ‘클로드’의 의견에 따라 정확히 이해는 못한 채 오늘 일단 테스트부터 했는데, 테스트 결과를 하나씩 정리하며 각 과정별 결과에 대한 클로드의 설명을 읽으면서 클로드가 시킨 테스트 방법의 이유, ‘추가학습’ 및 ‘RAG’의 차이를 이해할 수 있었다.
RAG가 뭐지?
우선, RAG가 뭐지?
RAG는 Retrieval-Augmented Generation(검색증강생성)의 약어로,
‘AI가 답변을 만들기 전 외부 문서·DB에서 관련 정보를 먼저 찾아본 뒤, 이를 바탕으로 답변을 정확하게 생성하는 AI 프레임워크’다.
클로드가 테스트 해보라고 했던 구체적인 내용은,
프롬프트를 입력할 때 “이 내용 참고해서 답해”라고 질문과 함께 관련 참고자료(RAG)를 함께 입력한 후,
SLM이 어떻게 대답하는지 확인해 보라는 거였다.
예를 들면,
어제 내가 SLM에게 물은 내용은 “반야심경 260자를 알려줘” 였는데,
오늘 RAG를 테스트 하기 위해서,
참고자료로 “반야심경 한글 해설본”을 프롬프트에 입력하면서,
같은 프롬프트에 “이 내용을 바탕으로 반야심경이 어떤 내용인지 100자 정도로 쉽게 풀어서 설명해줘”,
또는 “이 문장을 그대로, 자연스러운 구어체로만 다듬어서 말해줘.”라고 함께 질문하라는 거다.
근데 이걸 대체 왜 하라는 거지?
참고자료로 주라는 반야심경 한글 해설본은 총 622 글자로 그리 길지도 않은데..
굳이 이걸 프롬프트에 입력하고 이를 근거로 대답하라는 요구를 해보라는 이유가 대체 뭐지?
처음엔 이 테스트가 대체 뭘 확인해 보기 위해서 하라는 건지 이해가 가지 않았다.
결론부터 말하면,
SLM에 이 참고자료를 프로그램으로 넣어주는 수고를 하기 전에,
SLM이 “참고자료를 활용해서 답변할 만한 능력이 되는지”부터 확인하기 위함이었다.
답변을 위한 참고자료를 같은 프롬프트에 친절하게 넣어주는데도 제대로 대답을 못한다면,
프로그램을 이용해서 SLM에 참고자료를 잘 넣어준다 한들 그 참고자료를 이용해서 답변을 못할 것이기 때문이다.
처음에 클로드가 왜 이런 테스트를 해보라고 하는 거지 이해가 안 갔던 건, 내가 AI를 써본 경험은 모두 GPT, 클로드, 제미나이 같은 거대언어모형이었어서 실제로 테스트 해보기 전에는 아무리 소형모델이라 해도, 명색이 AI인데, 프롬프트로 함께 넣어주는 참고자료조차 제대로 활용 못할 수 있다는 생각 자체를 못해봤기 때문이었다.
SLM으로 RAG 테스트한 결과
지난 테스트에서 SLM 중에서도 가장 작은 모델인 1.5~3B를 사용한 건,
서피스프로8로 SLM을 실행시킬 수 있는가에 초점을 둔 테스트였기 때문이었다.
그래서 오늘 RAG 테스트는 llama의 3B, 8B 두가지 크기의 모델에서,
각각 다음의 세가지의 프롬프트를 주고 답변들을 비교해봤다.
① 반야심경 260자를 알려줘.
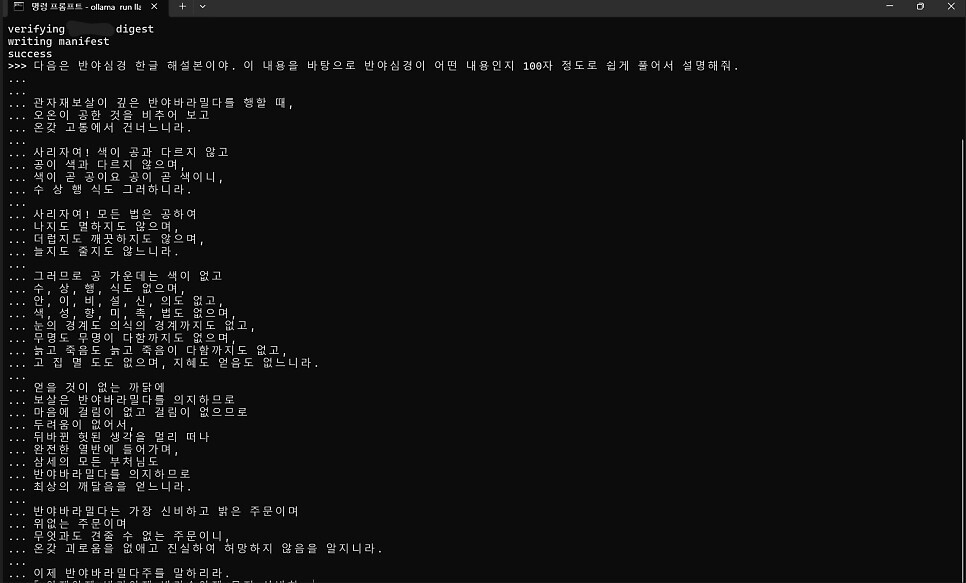
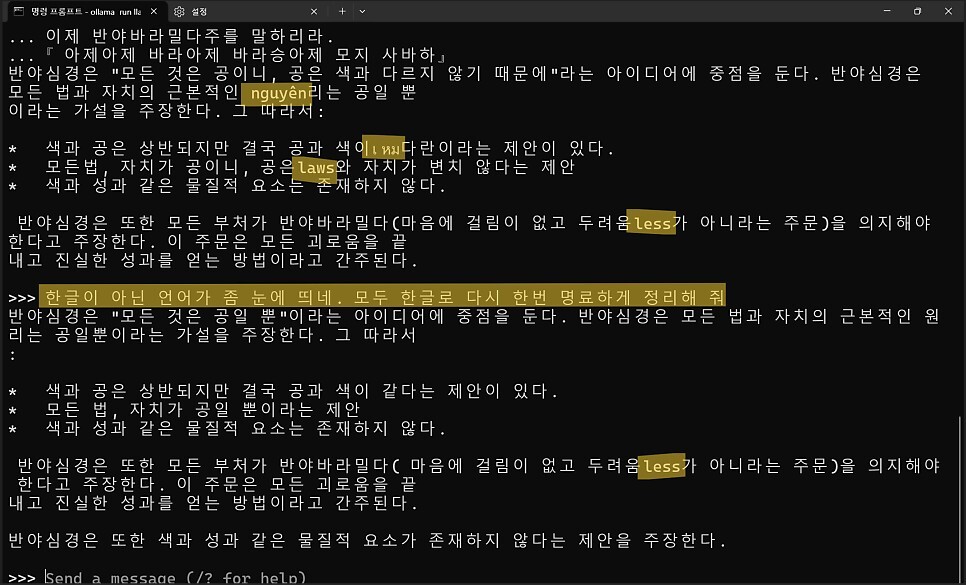
② 다음은 반야심경 한글 해설본이야. 이 내용을 바탕으로 반야심경이 어떤 내용인지 100자 정도로 쉽게 풀어서 설명해줘. (동일 프롬프트에 반야심경 한글 해설본 함께 줌)
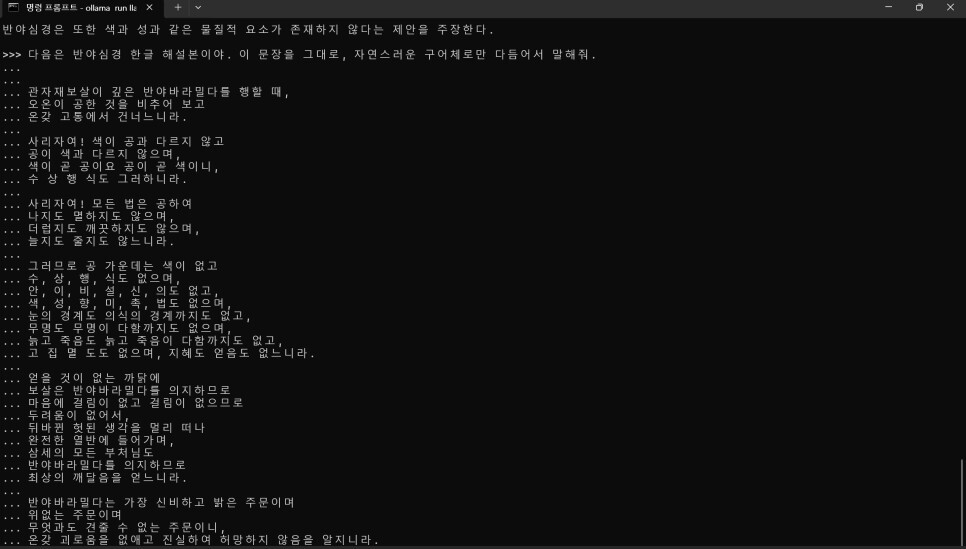
③ 다음은 반야심경 한글 해설본이야. 이 문장을 그대로, 자연스러운 구어체로만 다듬어서 말해줘. (동일 프롬프트에 반야심경 한글 해설본 함께 줌)
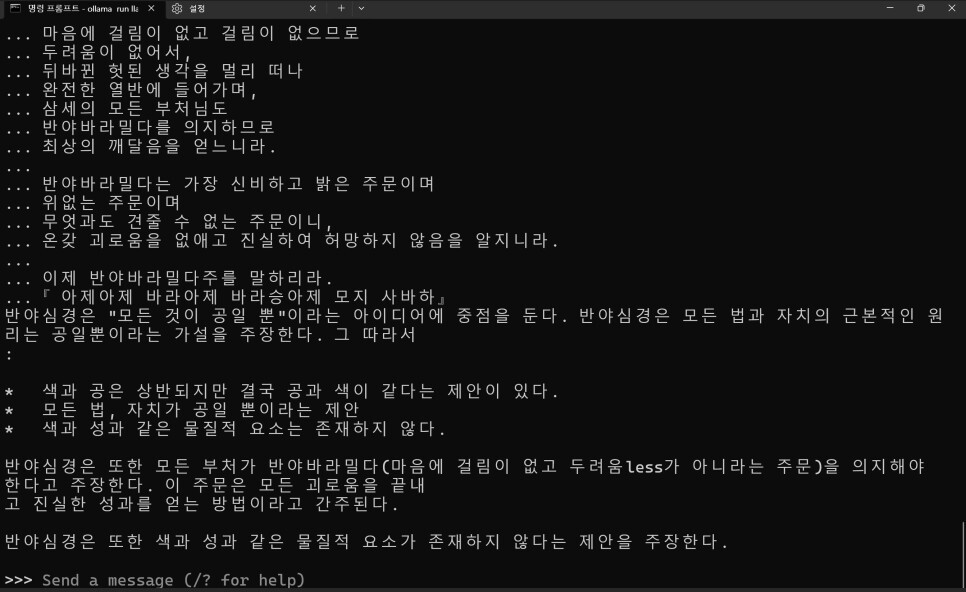
결과는 다음처럼..
RAG를 적용해서 8B모델을 사용한다면 계획대로 주지스님을 AI로 만들 수 있겠다는 생각이 들었다.
3B모델은.. 8B와 비교해서 결과의 차이가 눈에 보이게 달라서.. 불안해서 사용하지 못할 거 같다. 더 공부해보면 해결책이 있으려나.
아무튼 답변 결과로는 8B.
아, 참.. 8B는 서피스프로8로 로딩하는데 10~12분이 걸렸다.
게임하다가 숨넘어 가는거 아닌지.. 명상시간으로 세팅하는 방법이 있을라나 ㅋㅋㅋ
| 3B모델 | 8B모델 | 비고 | |
| 순수지식(RAG없이) – ① | 심각한 환각 | 여전히 환각 | 8B가 3B보다 더 매끄럽게 지어냄 |
| RAG 적용시 사실관계 – ② | 부분적 개선 | 양호 | 자료내용을 왜곡 없이 반영했는지 test함. ②의 “설명해줘”라는 질문에, 3B는 참고자료와 정반대의 모순되는 내용을, 8B는 참고자료와 일치하는 내용을 답함 |
| RAG 적용시 지시구분 능력 – ②&③ | 거의 안 됨 | 됨 | 요청사항의 종류에 따라 답변 방식을 바꿨는지 test함. 3B는 ②의 “설명해줘”에 대한 요약형 답변을 다음 질문인 ③의 “구어체로 다듬어줘”에 그대로 다시 해서, 지시가 바뀌었는데도 답변이 그대로임. 8B는 ②의 “설명해줘”에 요약형 답변을, ③의 “구어체로 다듬어줘”에 대해 원문을 거의 그대로 따라가며 구어체로 다듬은 형태로 지시에 따라 다르게 답변함 |
| RAG 적용시 언어 일관성 | 안 됨 | 됨 | 3B는 한국어, 영어, 베트남어, 아랍어 단어를 섞어서 답변, 8B는 한국어로만 답변 |
오늘은 여기까지
사실은 자정이 훌쩍 지나서 일단 잤고 지금은 다음날 아침이지만..
원래 이 글은
실제로 SLM에 RAG 참고자료를 입력하는 방법과,
그래서 다음에 이어서 할일은 뭔지 마저 정리하고,
이번 test를 진행하는 과정에서 아..하고 깨치게 됐던
AI를 “학습”시키는 것과 “RAG”를 적용하는 것이 구체적으로 어떻게 다르게 적용되는 건지 정리하고
마무리할 계획이었다.
이 부분은 바로 이어지는 다음 글에서 마저 정리하는 걸로, 마무리.
(2026.7.1. 네이버 블로그에 포스팅했던 글인데, 이곳으로 이사왔습니다.)
Q. RAG를 자동화하기 전에, SLM에게 프롬프트로 참고자료를 직접 주는 테스트를 하는 이유는 뭔가요?
A. 프로그램으로 참고자료를 자동으로 넣어주는 코드를 만들기 전에, SLM이 애초에 참고자료를 활용해서 답변할 능력이 되는지부터 확인하기 위해서 입니다. 프롬프트에 참고자료를 함께 넣어줘도 제대로 답하지 못한다면, 프로그램으로 자동화해도 마찬가지이기 때문입니다.
Q. Llama 3B와 8B 모델에 같은 참고자료(반야심경 해설본)를 줬을 때 결과가 다른가요?
A. 네, 확연히 다릅니다. 3B는 참고자료와 모순되는 답변을 하거나, 질문 종류가 바뀌어도 답변 방식을 거의 바꾸지 못했고, 한국어에 영어· 베트남어·아랍어가 섞여 나왔습니다. 8B는 참고자료 내용을 잘 반영하고, 질문 종류에 따라 답변 방식도 다르게 조정했으며, 한국어로만 일관되게 답했습니다.
Q. 서피스프로8에서 Llama 8B 모델은 로딩에 얼마나 걸리나요?
A. 10~12분 정도 걸렸습니다. 앞서 테스트한 1.5B~3B 모델(1.5~3.5분)보다 확실히 오래 걸리지만, 게임 플레이 중 대기 시간으로는 부담스러운 수준이었습니다.