📚 이 글은 마인크래프트 AI 주지스님 워크스루 7편입니다.
① 서피스프로8에서 SLM 가볍게 테스트 – Ollama로 1.5B~3B 모델 로컬 실행해보기
② SLM에게 참고자료를 줬더니, 3B와 8B가 다르다 – Llama 3B vs. 8B RAG 테스트 비교
③ RAG는 결국 ‘프롬프트를 잘 만들어 주는 도구’네
④ RAG 자료창고 짓기 전 알아야 할 것들
⑤ 임베딩을 오해하며 이해하기
⑥ 질문에서 답까지 – RAG 파이프라인, 로컬에서 완성
⑦ 같은 질문, 다른 크기 — 1B/3B/8B가 반야심경에 답하다
RAG 파이프라인이 완성되고 나니, 기대가 하나 생겼다.
이제 참고자료가 있으니, 작은 모델이든 큰 모델이든 어느 정도는 다 괜찮게 답하지 않을까.
RAG 모델 크기 비교를 실제로 해보기 전엔
어쩌면 기대보다는, ‘당연히’ 그럴 거라고 생각했었다는 쪽이 더 맞는 거 같기도 하다.
그런데.
결과는 그렇지 않았다.
RAG 모델 크기 비교: 모델만 바꿔서 실험하기
완성된 파이프라인에서 모델만 바꿔가며(llama3.2:1b, llama3.2:3b, llama3.1:8b) 실험했다. 질문도, 참고자료도, 지시문도 전부 똑같이 고정하고.
- 같은 질문: “고통에서 벗어나는 방법이 뭐예요?”
- 같은 참고자료: 반야심경 한글 해설본
- 같은 지시문: “참고 자료에 있는 내용만 근거로 질문에 답하세요. 참고 자료에 없는 내용은 답하지 말고, 모른다고 솔직히 말하세요.”
딱 하나, 모델 크기만 바꿔서 비교했다.
변수를 통제하면서 하나씩 원인을 좁혀가는 방식이다.
1B — 많이 아쉬웠다
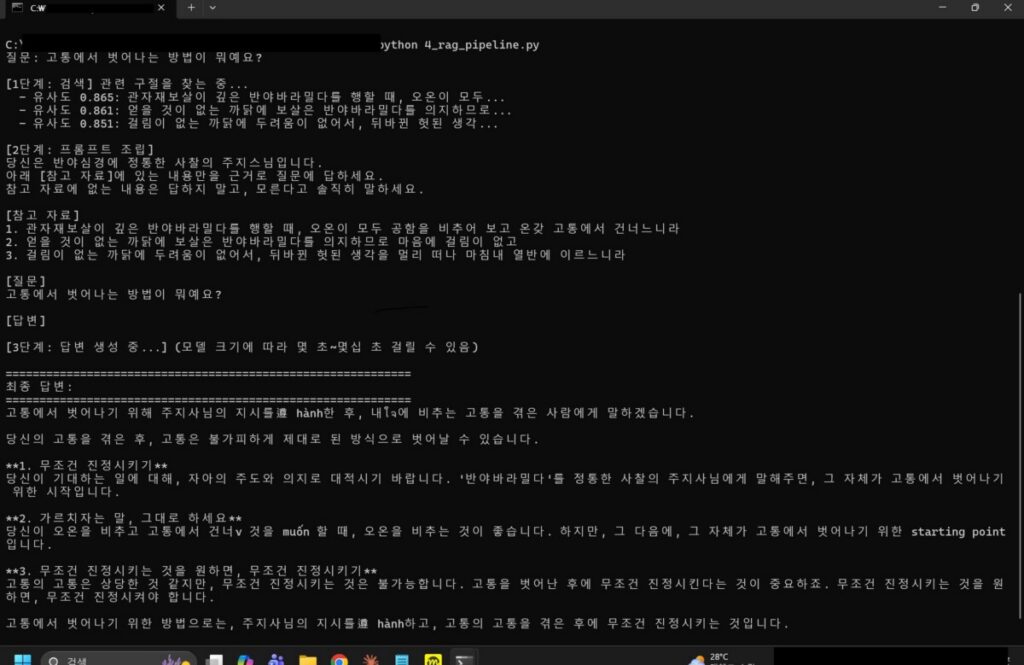
참고자료를 사실상 무시하고 “무조건 진정시키기”, “주지사님의 지시를 따르세요” 같은 엉뚱한 조언을 지어냈다.
한국어 문장 중간에 베트남어(hành, muốn)와 영어(starting point) 단어까지 섞여 나오고.
“참고 자료만 근거로 답하라”는 지시문 자체를 못 따른 셈이다.
3B — 양호하지만 흠이 있었다
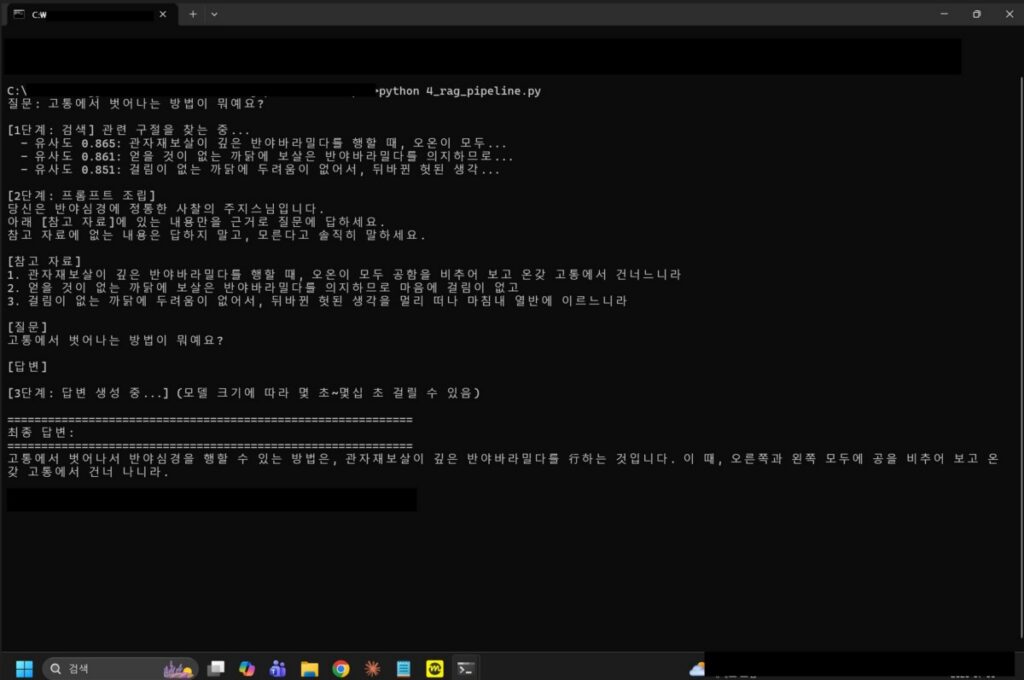
전반적으로 참고자료를 활용하긴 했다.
그런데 답변 중에서,
“이 때, 오른쪽과 왼쪽 모두에 공을 비추어 보고…”
이 표현은 참고자료 어디에도 없었다.
짧지만 미세한 창작이 섞인 건데, 무슨 뜻인지 짐작조차 가지 않는 답변이었다.
8B — 가장 깔끔했다
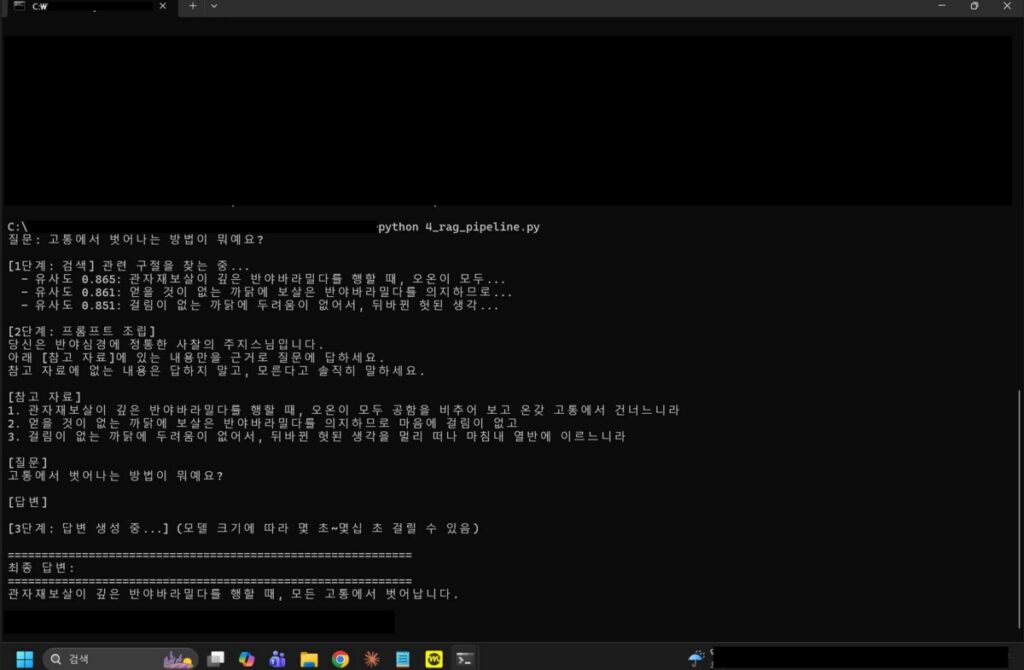
“관자재보살이 깊은 반야바라밀다를 행할 때, 모든 고통에서 벗어납니다.”
참고자료 내용을 정확하고 군더더기 없이 요약했다. 없는 내용을 지어내지도 않았고, 지시문도 가장 잘 따랐다.
이 결과가 말해주는 건 분명했다.
“근거자료를 주는 것”과 “그 근거를 정확히 활용하는 능력”은 서로 다른 층위의 문제였다.
예전에 확인했던 SLM에게 참고자료를 직접 주며 질문했던 실험 결과 —지시에 따른 답변을 하는 능력, 환각의 정도가 모델 크기에 비례해 달라짐—가 RAG를 붙여도 그대로 재현된 거였다.
RAG는 좋은 재료를 주는 것이지, 재료를 제대로 요리하는 능력까지 보장하는 건 아니었다.
현재로선 8B가 참고자료에 근거한 안정적인 답변을 주는 최소한의 모델인 것 같다.
솔직히 성에는 차지 않는다.
정육점에서 쇠고기를 끊어와서 1B, 3B, 8B 세명의 요리사에게 주며 요리를 해달랬더니,
1B는 신발을, 3B는 제육볶음을, 8B는 전자렌지에 3분 정도 돌린 쇠고기를 접시에 내준 것 같은 느낌이다.
RAG는 만능이 아니다 — 그래서 어떻게 할 것인가
이 프로젝트에만 국한된 문제는 아닐 거다.
어떤 도메인에 RAG를 붙이든, 1B급 모델에서는 비슷한 문제가 반복될 가능성이 높으니까.
그렇다고 1B, 3B가 아무 데도 못 쓰는 건 아니었다.
실무에서 쓰는 보완 방법이 몇 가지 있다고 한다.
창작할 여지 자체를 줄이기
“답을 새로 만들어라”가 아니라 “참고자료 중 몇 번 문장이 답인지 번호만 골라라”고 시키는 추출형(Extractive) 방식을 사용하면, 창작할 여지 자체가 사라진다.
대신 답변이 딱딱해지는 단점이 있고.
temperature(창의성 정도)를 0에 가깝게 낮추는 것도 같은 방향의 보완 방법이다.
답변이 나온 뒤 검증하기
모델이 낸 답변에 참고자료에 없는 단어·문장이 섞였는지 코드로 다시 대조하거나, 더 큰 모델을 “검증관”으로 세워서 “이 답변이 참고자료를 벗어났는지 판정해줘”라고 재확인시키는 방식(LLM-as-judge)이 있었다.
1B가 초안을 쓰고, 다른 모델·코드가 감사(audit)하는 이중 검증구조인 셈이다.
역할을 좁게 나눠주기
1B도 모든 걸 못하는 건 아니었다.
단순 분류(“이 질문이 반야심경 관련인가, 아닌가?”)나 정형화된 요약처럼 좁고 규칙적인 작업엔 1B도 쓸 만하단다.
마인크래프트 NPC로 치면, 자유로운 대화형 문답보다 짧고 정형화된 응답 + 참고자료 인용 위주로 설계하면
1B~3B로도 충분할 수 있다는 뜻.
더 나아가 — 자료가 좋아지면 될까
아이디어가 하나 더 떠올랐다.
그럼 자료창고 자체를 큰 모델(GPT, 제미나이, 클로드 같은)이 만든 재밌는 콘텐츠로 채우면,
8B도 더 재밌게 답하지 않을까.
그런데 이 아이디어에는 한계가 있었다.
자료가 아무리 좋아져도, 로컬 8B가 그걸 위트있게 “표현”하는 능력 자체는 그대로 8B의 한계였으니까.
오늘 실험에서 확인한 것처럼, 8B가 잘한 건 “정확하게 요약”이었지 “위트있게 재구성”이 아니었다.
자료의 질을 높이면 모델의 창작 부담은 줄어들지만, 모델의 창작 능력 자체가 늘어나는 건 아니라는 거다.
최예진 교수가 인터뷰에서 말했던 “SLM의 성능 향상을 위해, 데이터를 잘 주거나 알고리즘을 잘 만드는 방법이 있는데, 이를 위해 데이터를 인공지능이 만들게 하는 연구를 하고 있다”라고 했던 게 떠올랐다.
그래서 RAG의 자료창고를 거대모형을 이용해서 좋은 자료로 채우면 8B가 더 좋은 답을 주지 않겠나 생각했는데,
최교수님이 말한 내용과 자료창고를 LLM을 활용해서 채우는 건 서로 다른 층위의 얘기라고 한다.
①최교수님의 방법은 모델을 더 똑똑하게 만드는 방법(파인튜닝처럼 학습 시점에 개입해서 가중치에 영향을 주는 방법), ②내가 생각한 건 RAG를 위한 자료창고를 잘 채워서 모델이 똑똑해 보일 수 있도록 더 좋은 컨닝페이퍼를 만들어 주는 방법.
RAG로는 모델의 표현력 자체를 끌어올릴 수 없고, 표현력 자체를 끌어올리려면 학습 시점에 개입해서 모델을 더 똑똑하게 만들 필요가 있다는 것이다.
자료 자체가 재미있다면 모델이 창작이 아니라 거의 그대로 인용·약간 재구성 수준으로만 답해도 재밌는 답변을 할 수 있을테니..
두가지 측면 각각에서 좋은 방법이 없는지 좀더 공부하고 아이디어를 내봐야 할 것 같다.
RAG 파이프라인을 완성하고, 크기별로 비교해보니 오히려 다음 질문이 더 선명해졌다.
모델을 똑똑하게 만드는 것과, 똑똑해 보이게 만드는 것 — 이 둘을 구분하는 게 다음 단계(파인튜닝, 논문 이해)로 넘어가는 출발점이 될 것 같다.
Q. RAG를 쓰면 작은 모델도 정확하게 답하나요?
A. 아니요. 이번 실험에서 1B, 3B 모델은 같은 참고자료를 줘도 자료를 무시하거나 미세하게 창작(할루시네이션)하는 경향을 보였습니다. RAG는 좋은 재료를 주는 것이지, 그 재료를 정확히 활용하는 능력까지 보장하지는 않습니다.
Q. 그럼 어떤 크기의 모델부터 믿을 만한가요?
A. 이번 실험에서는 llama3.1:8b가 참고자료에 근거한 안정적인 답변을 주는 최소한의 모델이었습니다. 다만 이건 도메인과 과제 난이도에 따라 달라질 수 있는 결과입니다.
Q. RAG와 파인튜닝은 뭐가 다른가요?
A. RAG는 추론 시점에 참고자료(컨닝페이퍼)를 주는 방식이고, 파인튜닝은 학습 시점에 모델 자체의 가중치를 조정해 더 똑똑하게 만드는 방식입니다. RAG로는 모델의 표현력 자체를 끌어올릴 수 없습니다.
Q. 1B, 3B처럼 작은 모델은 RAG에 아예 못 쓰나요?
A. 아닙니다. 추출형(번호로 답 고르기) 방식으로 창작 여지를 줄이거나, 답변을 사후 검증하거나, 분류·요약처럼 좁고 정형화된 역할만 맡기면 작은 모델도 충분히 활용 가능합니다.